01. Oktober 2026
Wie lernen humanoide Roboter? VLA-Modelle, Trainingsdaten und Simulation verständlich erklärt
Wie lernen humanoide Roboter? Teleoperation, Videos von Menschen, Simulation und Vision-Language-Action-Modelle wie Helix, GR00T und Gemini Robotics erklärt.
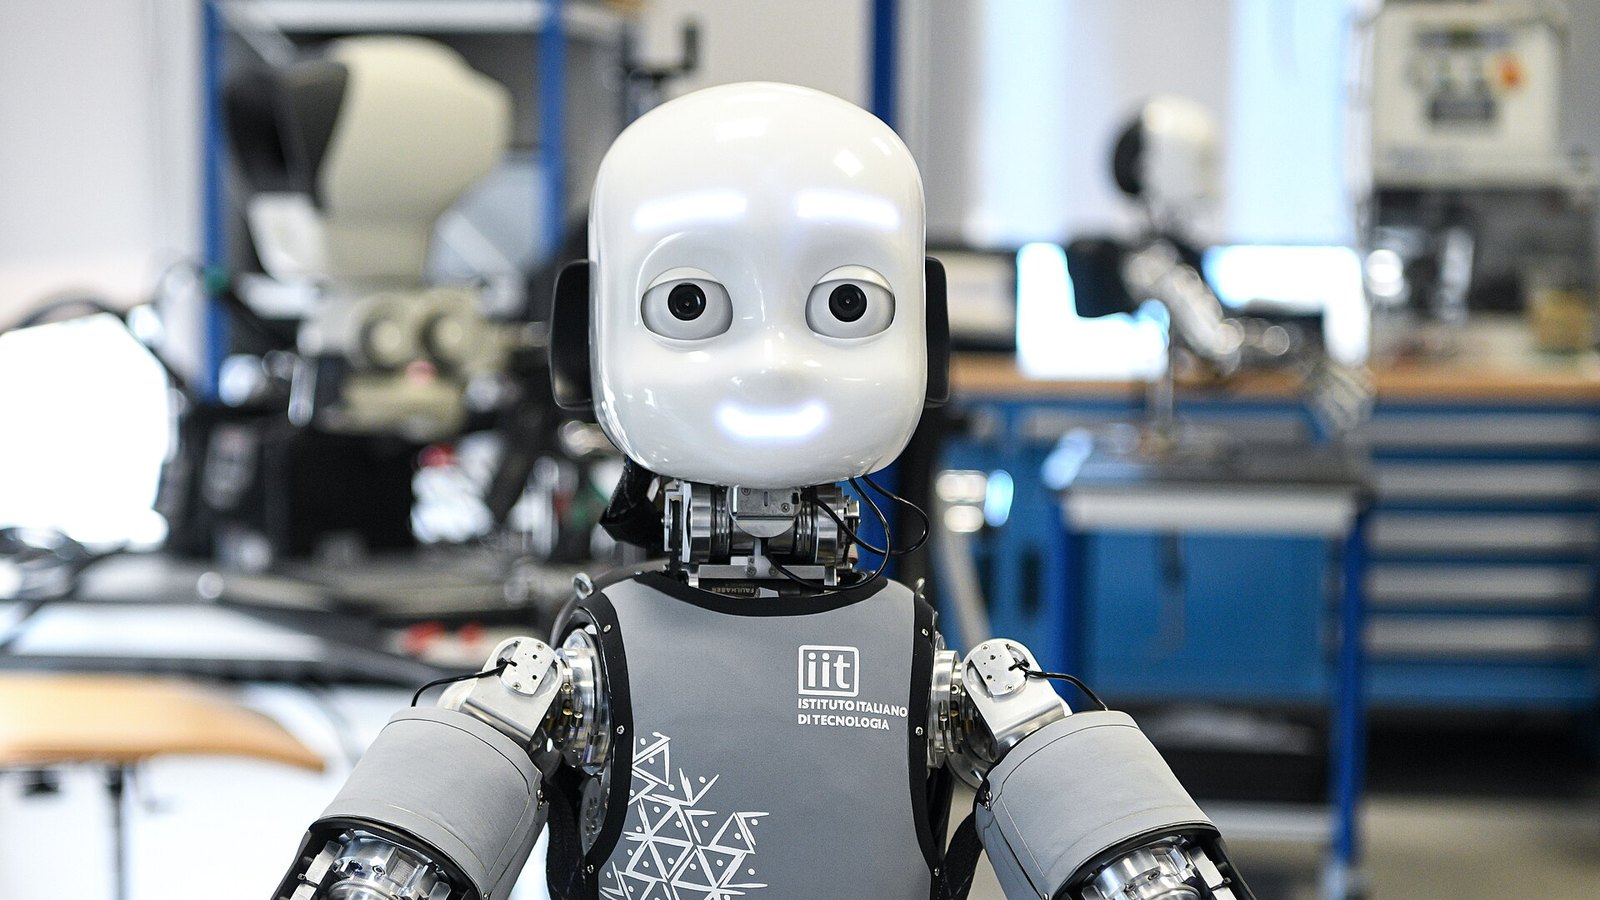
Bild: Piero Cruciatti / European Commission, via Wikimedia Commons · CC BY 4.0
Humanoide Roboter lernen heute vor allem durch Nachahmung und durch Übung in der Simulation. Menschen zeigen ihnen Aufgaben vor, entweder per Fernsteuerung oder in Videos, und ein großes KI-Modell lernt daraus, welche Bewegung in welcher Situation passt. Das Laufen und Balancieren trainieren die Roboter dagegen meist in virtuellen Welten, in denen sie Millionen von Versuchen in kurzer Zeit absolvieren. Das Herzstück vieler aktueller Systeme ist ein sogenanntes Vision-Language-Action-Modell, kurz VLA. Dieser Ratgeber erklärt, wie diese Lernverfahren funktionieren, woher die Daten kommen und warum sie über Erfolg und Misserfolg der ganzen Branche entscheiden.
Die kurze Antwort: Drei Wege, wie Roboter lernen
Wer verstehen will, wie ein humanoider Roboter zu seinen Fähigkeiten kommt, kann sich drei grundlegende Lernwege merken.
| Lernweg | Wie es funktioniert | Wofür es vor allem genutzt wird |
|---|---|---|
| Imitationslernen | Der Roboter ahmt aufgezeichnete Vorführungen von Menschen nach | Greifen, Sortieren, Hausarbeit, Montage |
| Reinforcement Learning | Der Roboter probiert aus und wird für Erfolg belohnt, meist in der Simulation | Laufen, Balance, Aufstehen, Ganzkörperbewegung |
| Vortraining mit Internetwissen | Ein Sprach- und Bildmodell bringt allgemeines Weltwissen mit | Anweisungen verstehen, Objekte erkennen, Aufgaben planen |
In der Praxis werden diese Wege kombiniert. Ein Vision-Language-Action-Modell nutzt das Vorwissen aus Text und Bildern, wird mit Vorführungen von Menschen weitertrainiert und arbeitet oft mit einem Laufregler zusammen, der in der Simulation gelernt hat.
Vom Programmieren zum Lernen: Warum sich alles geändert hat
Klassische Industrieroboter werden programmiert. Ein Ingenieur legt fest, an welchen Punkt der Greifer fährt, mit welcher Geschwindigkeit und in welcher Reihenfolge. Das funktioniert hervorragend, solange jedes Bauteil immer an derselben Stelle liegt. Ein Schweißroboter in der Autofabrik muss nicht verstehen, was er tut.
Humanoide Roboter sollen aber genau dort arbeiten, wo nichts fest vorgegeben ist: in Lagerhallen mit wechselnden Kartons, in Werkstätten mit verschiedenen Bauteilen und irgendwann in Wohnungen, in denen jede Küche anders aussieht. Für solche Umgebungen lässt sich nicht jede Bewegung vorab programmieren. Der Roboter muss selbst erkennen, was vor ihm liegt, und eine passende Bewegung erzeugen.
Deshalb setzt die Branche seit einigen Jahren auf maschinelles Lernen. Statt Regeln zu schreiben, sammeln Entwickler Beispiele und lassen ein neuronales Netz daraus ableiten, wie es handeln soll. Dieser Wechsel ist der Kern dessen, was heute unter Physical AI verstanden wird.
Was ist ein Vision-Language-Action-Modell?
Ein Vision-Language-Action-Modell ist ein neuronales Netz, das drei Dinge verbindet: Es sieht, es versteht Sprache und es erzeugt Bewegungen. Als Eingabe bekommt es Kamerabilder und eine Anweisung wie „Leg die Handtücher zusammen”. Als Ausgabe liefert es Steuerbefehle für Gelenke, Hände und manchmal den ganzen Körper.
Der Begriff wurde 2023 von Google DeepMind mit dem Modell RT-2 geprägt. Die Idee dahinter: Große Sprach- und Bildmodelle haben aus dem Internet bereits viel über die Welt gelernt. Sie wissen, wie eine Tasse aussieht, dass man sie am Henkel greift und dass sie in den Schrank gehört. Ein VLA nutzt dieses Wissen und ergänzt es um das, was im Internet fehlt: die Verbindung von Bild und Bewegung.
Zwei Geschwindigkeiten: Denken und Reflexe
Viele aktuelle VLA-Modelle für Humanoide arbeiten mit zwei Ebenen, die oft mit dem menschlichen Denken verglichen werden. Eine langsamere Ebene versteht die Szene und die Aufgabe. Eine schnelle Ebene setzt das in flüssige Bewegungen um.
Ein gut dokumentiertes Beispiel ist Helix von Figure, im Februar 2025 vorgestellt. Die langsame Ebene, von Figure „System 2” genannt, ist ein Bild-Sprach-Modell mit 7 Milliarden Parametern, das 7 bis 9 Mal pro Sekunde eine neue Einschätzung liefert. Die schnelle Ebene, „System 1”, ist ein deutlich kleineres Netz mit rund 80 Millionen Parametern. Sie erzeugt 200 Mal pro Sekunde neue Steuerbefehle für den Oberkörper bis hinunter zu den einzelnen Fingern. Trainiert wurde die erste Helix-Version laut Figure mit rund 500 Stunden Daten aus Fernsteuerung.
Auch NVIDIA trennt bei seinen GR00T-Modellen zwischen langsamem Schlussfolgern und schnellen Reflexen. Google DeepMind lässt seine Gemini-Robotics-Modelle zuerst in Sprache über die Aufgabe nachdenken und dann handeln. Physical Intelligence, ein Start-up aus San Francisco, erzeugt bei seinen π-Modellen die Bewegungen mit einem Verfahren, das an Bildgeneratoren erinnert und fließende Bewegungsabläufe statt einzelner Befehle liefert.
Die wichtigsten Robotermodelle im Überblick
| Modell | Entwickler | Besonderheit |
|---|---|---|
| Helix (aktuell Helix 2.5) | Figure AI | Läuft auf dem eigenen Humanoiden Figure 03, Vortraining mit Videos von Menschen |
| GR00T | NVIDIA | Offenes Basismodell für viele Roboterhersteller, eng mit Simulation verknüpft |
| Gemini Robotics | Google DeepMind | Baut auf Gemini auf, Partner unter anderem Apptronik |
| π-Modelle | Physical Intelligence | Herstellerunabhängig, für verschiedene Robotertypen trainiert |
| Large Behavior Model | Boston Dynamics mit Toyota Research Institute | Für Ganzkörperaufgaben des Atlas entwickelt |
Woher kommen die Trainingsdaten?
Ein Sprachmodell wie ChatGPT konnte aus Milliarden Texten im Internet lernen. Für Roboter gibt es so einen Schatz nicht. Niemand hat jahrzehntelang aufgezeichnet, welche Gelenkwinkel und Greifkräfte nötig sind, um eine Spülmaschine auszuräumen. Diese Daten müssen erst erzeugt werden. Genau deshalb gilt der Datenmangel als der größte Engpass der Branche. Unser Monatsrückblick September 2026 hat das als einen von drei großen Trends herausgearbeitet: Daten sind der neue Flaschenhals.
Heute nutzen die Hersteller vier Datenquellen.
1. Teleoperation: Der Mensch steuert, der Roboter lernt
Bei der Teleoperation steuert ein Mensch den Roboter aus der Ferne, oft mit einer VR-Brille und Handschuhen oder Controllern, die jede Hand- und Fingerbewegung erfassen. Der Roboter führt die Bewegungen aus, und alles wird aufgezeichnet: Kamerabilder, Gelenkwinkel, Greifkraft. Diese Daten sind besonders wertvoll, weil sie exakt zum Körper des Roboters passen.
Der Nachteil: Teleoperation ist teuer und langsam. Für jede Stunde Daten braucht man eine Stunde menschlicher Arbeit plus einen Roboter. In China ist daraus inzwischen ein eigener Wirtschaftszweig geworden. Bis Ende 2025 gab es dort nach Medienberichten mehr als 40 staatlich unterstützte Datenzentren für Roboter, von denen 24 bereits arbeiteten. Ein Zentrum in Zigong in der Provinz Sichuan mit 6.000 Quadratmetern soll bei voller Auslastung bis zu drei Millionen Datensätze pro Jahr erzeugen. Auch AgiBot, Hersteller des AgiBot A2, betreibt in Shanghai eine große Halle, in der Menschen mit VR-Brillen Roboter durch Alltagsaufgaben führen.
2. Videos von Menschen: Lernen durch Zuschauen
Die zweite Quelle sind Videos, in denen Menschen Aufgaben erledigen. Sie sind viel billiger zu bekommen als Teleoperationsdaten und lassen sich in großen Mengen sammeln. Ihr Nachteil: Ein Video zeigt keine Kräfte und keine Gelenkwinkel des Roboters. Das Modell muss selbst übersetzen, wie die Bewegung einer menschlichen Hand auf eine Roboterhand passt.
Tesla hat 2025 laut übereinstimmenden Medienberichten genau diesen Weg eingeschlagen. Statt Mitarbeiter in Motion-Capture-Anzügen den Tesla Optimus fernsteuern zu lassen, tragen sie Helme und Rucksäcke mit fünf Kameras und filmen sich bei Tätigkeiten wie dem Falten eines T-Shirts. Das Ziel ist Skalierung: Videos lassen sich viel schneller sammeln als Fernsteuerdaten. Ein Robotikforscher wandte in diesem Zusammenhang ein, dass Video allein dem Roboter die körperliche Erfahrung nicht ersetzt, die er bei der Teleoperation sammelt.
Figure geht einen ähnlichen Weg mit seinem Datensatz Index. Freiwillige filmen dort per App ihre Handgriffe aus der Ich-Perspektive. Was das bringt, zeigte Figure im September 2026 mit Helix 2.5 auf dem Figure 03: In 30 fremden Wohnungen erledigte der Roboter 56 Prozent der Aufgaben vollständig, ohne dass dort vorher Daten gesammelt worden waren. Ohne das Vortraining mit Index lag die Quote nur im einstelligen Prozentbereich.
3. Simulation: Millionen Versuche am Computer
Die dritte Quelle sind physikalische Simulationen. Hier bewegt sich ein virtuelles Abbild des Roboters in einer berechneten Welt mit Schwerkraft, Reibung und Kollisionen. Der große Vorteil: Tausende virtuelle Roboter können gleichzeitig üben, auf einer Grafikkarte, rund um die Uhr, ohne dass etwas kaputtgeht.
Das wichtigste Verfahren dafür ist Reinforcement Learning, also Lernen durch Belohnung. Der virtuelle Roboter probiert Bewegungen aus. Bleibt er stehen und kommt voran, gibt es Punkte. Fällt er um, gibt es Abzüge. Nach Millionen Versuchen hat das Netz gelernt, stabil zu laufen. NVIDIA stellt dafür mit Isaac Lab ein offenes Werkzeug bereit, das viele Hersteller und Hochschulen nutzen.
Die Schwierigkeit heißt „Sim-to-Real”, die Übertragung von der Simulation in die echte Welt. Keine Simulation bildet Reibung, Materialverhalten und Sensorrauschen perfekt ab. Entwickler verändern deshalb absichtlich Parameter wie Bodenbeschaffenheit, Gewicht oder Motorstärke in der Simulation zufällig. So lernt der Roboter, mit Abweichungen umzugehen, und kommt in der Realität besser zurecht. Dieses Vorgehen hat entscheidend dazu beigetragen, dass Humanoide wie der Unitree G1 heute erstaunlich sicher laufen und nach einem Stoß das Gleichgewicht halten.
4. Daten aus dem echten Einsatz
Die vierte Quelle wird mit jedem ausgelieferten Roboter wichtiger: Daten aus der Praxis. Wenn Roboter in Fabriken oder Lagern arbeiten, sammeln sie Erfahrungen, die in kein Labor passen. Unerwartete Situationen, Fehler und Korrekturen durch Menschen sind besonders lehrreich.
Darauf setzen mehrere Kooperationen. Apptronik sammelt mit dem Apptronik Apollo Daten für Google DeepMind, per Fernsteuerung, im autonomen Betrieb und in Simulationen. Boston Dynamics trainiert den Atlas im Anwendungszentrum bei Hyundai in Georgia an echten Aufgaben aus der Autofertigung. Und das deutsche Unternehmen Neura Robotics plant mit seinem Partner SECO ein eigenes Trainingszentrum in Italien, um Daten aus Industrieeinsätzen zu gewinnen.
Große Datensätze: Das „Internet” für Roboter entsteht
Weil einzelne Firmen kaum genug Daten sammeln können, sind in den vergangenen Jahren auch gemeinsame und offene Datensätze entstanden.
| Datensatz | Herausgeber | Umfang |
|---|---|---|
| Open X-Embodiment | Google DeepMind mit über 20 Forschungseinrichtungen | Über 1 Million Episoden von 22 verschiedenen Robotertypen |
| AgiBot World | AgiBot | Über 1 Million Bewegungsabläufe, knapp 3.000 Stunden, 217 Aufgaben |
| Index | Figure AI | Videos menschlicher Alltagshandlungen, nicht öffentlich |
Open X-Embodiment zeigte 2023 erstmals im großen Stil, dass ein Modell von den Daten ganz unterschiedlicher Roboter profitiert. Ein Greifarm kann also indirekt von einem anderen Roboterarm lernen. AgiBot World ist auf Humanoide und Zweiarmroboter ausgerichtet und wurde offen zur Verfügung gestellt. Laut AgiBot schnitten Modelle, die damit vortrainiert wurden, im Mittel um 30 Prozent besser ab als solche mit Open X-Embodiment. Das ist eine Herstellerangabe, aber sie zeigt, wie stark die Qualität der Daten das Ergebnis beeinflusst.
Wie aus Daten eine Fähigkeit wird: Der Ablauf in vier Schritten
Vereinfacht durchläuft ein Humanoid heute folgende Stufen, bis er eine Aufgabe beherrscht.
Schritt 1: Vortraining. Ein großes Modell lernt aus Internettexten, Bildern und Videos allgemeines Wissen über Gegenstände, Räume und menschliche Handlungen.
Schritt 2: Robotertraining. Das Modell wird mit Roboterdaten weitertrainiert, also mit Teleoperation, Simulation und gemischten Datensätzen. Hier lernt es, Bild und Sprache mit konkreten Bewegungen zu verknüpfen.
Schritt 3: Anpassung an die Aufgabe. Für einen bestimmten Einsatz, etwa das Sortieren von Teilen an einem Fließband, werden zusätzliche Vorführungen gesammelt. Mit einem guten Basismodell reichen dafür oft deutlich weniger Daten als früher.
Schritt 4: Test und Rückkopplung. Der Roboter arbeitet unter Aufsicht. Fehler werden erfasst, korrigiert und fließen ins nächste Training ein. Die verbesserte Version kommt per Software-Update auf den Roboter.
Wichtig für Betreiber: Der Roboter lernt in aller Regel nicht unkontrolliert vor Ort weiter. Neues Verhalten entsteht zentral beim Hersteller, wird getestet und dann verteilt. Das ist auch eine Sicherheitsfrage, denn ein Roboter, der sich unbemerkt selbst verändert, wäre kaum abzunehmen.
Wo das Lernen heute noch scheitert
So beeindruckend die Fortschritte sind, die Grenzen sind deutlich.
Zuverlässigkeit. 56 Prozent Erfolgsquote in fremden Wohnungen sind ein Rekord, bedeuten aber auch, dass fast jede zweite Aufgabe scheitert. In der Industrie werden meist Quoten weit über 99 Prozent erwartet. Der Weg dorthin ist mühsam, weil die letzten Prozent die seltenen und schwierigen Fälle betreffen.
Fingerspitzengefühl. Kameras sehen nicht, wie fest ein Gegenstand gegriffen wird. Viele Humanoide haben noch keine oder nur einfache Tastsensoren in den Fingern. Aufgaben wie das Einfädeln eines Kabels oder das Aufheben eines rohen Eis bleiben schwierig.
Übertragbarkeit. Was ein Modell auf einem Robotertyp gelernt hat, funktioniert auf einem anderen Körper nicht automatisch. Unterschiedliche Hände, Gelenke und Kameras erfordern Anpassung.
Erklärbarkeit. Ein VLA-Modell entscheidet als neuronales Netz. Warum es in einer Situation falsch gegriffen hat, lässt sich oft nicht genau nachvollziehen. Für die Sicherheitsbewertung nach der europäischen Maschinenverordnung, die ab dem 20. Januar 2027 gilt, ist das eine echte Herausforderung. Mehr dazu steht in unserem Ratgeber Sind humanoide Roboter sicher?.
Was das für Käufer und Betreiber bedeutet
Für Unternehmen, die einen Humanoiden einsetzen wollen, ist die Lernfrage keine akademische. Sie entscheidet darüber, wie schnell ein Roboter produktiv wird und wer welche Arbeit leisten muss.
Fragen Sie nach dem Basismodell. Ein Hersteller mit einem starken vortrainierten Modell braucht für Ihre Aufgabe weniger eigene Vorführungen. Das spart Zeit und Geld in der Pilotphase.
Klären Sie, wer die Daten sammelt. Bei manchen Anbietern übernimmt der Hersteller die Anlernphase, bei anderen müssen eigene Mitarbeiter per Fernsteuerung Beispiele liefern. Das sollte im Angebot stehen.
Regeln Sie die Datennutzung. Daten aus Ihrem Betrieb sind für den Hersteller wertvoll, weil sie sein Modell verbessern. Vertraglich sollte feststehen, welche Daten das Werk verlassen dürfen und ob Kamerabilder von Mitarbeitern betroffen sind. Hier greift auch die Datenschutz-Grundverordnung.
Planen Sie Updates ein. Neue Fähigkeiten kommen per Software. Klären Sie, wie Updates getestet und freigegeben werden und ob nach einem Update eine neue Risikobeurteilung nötig ist.
Welche Modelle es überhaupt gibt und wie sie sich in Preis, Größe und Verfügbarkeit unterscheiden, zeigt unser großer Vergleich humanoider Roboter. Praktische Hinweise zur Einführung im Unternehmen bietet der Ratgeber Humanoiden Roboter im Betrieb einsetzen.
Ausblick: Wohin sich das Robotertraining entwickelt
Drei Entwicklungen zeichnen sich für die nächsten Jahre ab.
Erstens werden Videodaten von Menschen weiter an Bedeutung gewinnen. Wenn ein Roboter aus normalen Videos lernen kann, steht ihm im Prinzip ein riesiger Fundus offen. Tesla hat bereits angedeutet, dass Optimus künftig auch aus Videos lernen soll, die Menschen aus der Außenperspektive zeigen, also nicht nur aus Aufnahmen mit Kopfkameras.
Zweitens rücken sogenannte Weltmodelle in den Fokus. Das sind KI-Modelle, die vorhersagen, wie sich eine Szene verändert, wenn der Roboter eine bestimmte Bewegung macht. Damit kann ein Roboter Handlungen gewissermaßen im Kopf durchspielen, bevor er sie ausführt. NVIDIA hat für die nächste GR00T-Generation einen solchen Ansatz angekündigt.
Drittens wird die Zahl der Roboter im Einsatz selbst zum Datenmotor. Je mehr Humanoide in Fabriken, Lagern und Haushalten arbeiten, desto mehr reale Erfahrung fließt zurück. Wer früh viele Roboter im Feld hat, verbessert sein Modell schneller. Das erklärt, warum Hersteller wie Figure, Tesla, AgiBot und auch Neuzugänge wie OpenAI so viel Wert auf eigene Datenkreisläufe legen. Wer die wichtigsten Anbieter und ihre Strategien kennenlernen möchte, findet sie in unserer Übersicht der Hersteller humanoider Roboter.
Fazit
Humanoide Roboter lernen heute ähnlich, wie große Sprachmodelle lernen: aus sehr vielen Beispielen. Vision-Language-Action-Modelle verbinden Sehen, Sprache und Bewegung, Reinforcement Learning in der Simulation bringt ihnen Laufen und Balance bei. Der eigentliche Wettbewerb dreht sich inzwischen weniger um Motoren und Gelenke als um Daten. Wer die meisten und besten Beispiele hat, baut die geschicktesten Roboter. Für Käufer heißt das: Bei der Auswahl eines Humanoiden zählt nicht nur die Hardware, sondern auch, wie gut das KI-Modell dahinter ist und wie es weiterlernt.
Häufige Fragen
Was ist ein Vision-Language-Action-Modell (VLA)?+
Ein Vision-Language-Action-Modell ist ein neuronales Netz, das Kamerabilder und Sprachanweisungen als Eingabe bekommt und daraus direkt Bewegungsbefehle für einen Roboter erzeugt. Es verbindet also Sehen, Sprachverständnis und Motorsteuerung in einem Modell. Bekannte Beispiele sind Figure Helix, NVIDIA GR00T, Google DeepMind Gemini Robotics und die π-Modelle von Physical Intelligence.
Woher bekommen humanoide Roboter ihre Trainingsdaten?+
Aus vier Quellen: Teleoperation, bei der ein Mensch den Roboter fernsteuert und jede Bewegung aufgezeichnet wird, Videos von Menschen bei Alltagsarbeiten, Simulationen mit Millionen virtueller Versuche und den Daten, die Roboter im echten Einsatz selbst sammeln. Die meisten Hersteller kombinieren mehrere Quellen.
Lernt ein humanoider Roboter bei mir zu Hause oder im Betrieb selbstständig weiter?+
In der Regel nicht direkt. Heutige Systeme werden zentral beim Hersteller trainiert und erhalten neue Fähigkeiten per Software-Update. Daten aus dem Einsatz können in dieses Training zurückfließen, wenn der Betreiber zustimmt. Ein Roboter, der sich vor Ort ohne Kontrolle selbst umprogrammiert, ist nicht der Stand der Technik.
Warum laufen humanoide Roboter heute so viel besser als vor zehn Jahren?+
Vor allem wegen Reinforcement Learning in der Simulation. Laufregler werden heute in physikalischen Simulationen mit sehr vielen parallelen virtuellen Robotern trainiert und anschließend auf die echte Hardware übertragen. Dazu kommen leichtere, stärkere Antriebe und bessere Sensoren.
Wie lange dauert es, einem humanoiden Roboter eine neue Aufgabe beizubringen?+
Das hängt stark von der Aufgabe und vom Basismodell ab. Mit einem großen vortrainierten Modell reichen für eine neue, ähnliche Aufgabe oft einige Stunden bis wenige Dutzend Stunden an Demonstrationen. Völlig neue Fähigkeiten, etwa feinfühliges Arbeiten mit unbekannten Werkzeugen, brauchen deutlich mehr Daten und Tests, bevor sie zuverlässig laufen.
Passende Roboter-Modelle